自动化监控体系保障台湾站群日常运维与故障响应速度
2026年10月20日
1.
总体架构与目标设定
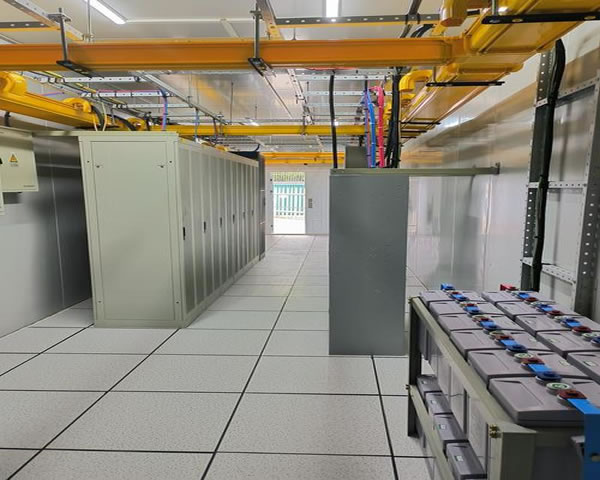
目标:建立覆盖可用性、性能、日志与合规的自动化监控体系,目标RTO/RPO与SLA在部署前确认。小分段:列出站点清单(域名、IP、服务类型、机房/云区域),确认监控边界与权限账号(只读/运维)。
2.
选型与组件清单
推荐组件:Prometheus + node_exporter、Grafana、Alertmanager、Fluent Bit/Logstash、Elasticsearch、Filebeat、Blackbox Exporter、Synthetic监测(Synthetics或自建Playwright脚本)。小分段:备选:Zabbix用于传统设备,Opsgenie/PagerDuty或Slack作为告警通道,Ansible或Terraform用于自动化运维。
3.
基础设施准备
在台湾机房或近台云区部署:准备监控节点(建议最少2个Prometheus HA,2个Alertmanager HA,1个Grafana)。小分段:系统要求:Linux (Ubuntu/CentOS),开放端口:9090,3000,9093,设置时区为Asia/Taipei,时钟同步使用chrony/ntp。
4.
Prometheus与Exporter部署步骤
步骤1:在监控节点安装Prometheus二进制或用Docker:docker run -d --name prometheus -p 9090:9090 -v /etc/prometheus:/etc/prometheus prom/prometheus。小分段:步骤2:部署node_exporter:docker run -d --name node_exporter -p 9100:9100 prom/node-exporter。配置Prometheus scrape_configs,示例:
- job_name: 'node' static_configs: - targets: ['10.0.0.1:9100']
5.
Blackbox与合成监测配置
部署blackbox_exporter用于HTTP/HTTPS/ICMP探测。步骤:docker run -d --name blackbox -p 9115:9115 prom/blackbox-exporter。小分段:在Prometheus中新增job:
- job_name: 'http_probe' metrics_path: /probe params: module: [http_2xx] static_configs: - targets: ['https://site-tw.example.com'] relabel_configs: - source_labels: [__address__] target_label: __param_target - source_labels: [__param_target] target_label: instance - target_label: __address__ replacement: 127.0.0.1:9115
6.
日志收集与聚合实操
推荐使用Fluent Bit采集容器/主机日志并输出到Elasticsearch或Logstash。示例配置:inputs: tail path /var/log/nginx/access.log parser nginx。小分段:部署步骤:1) 安装Fluent Bit 2) 配置输出到Elasticsearch 3) 在Kibana/Grafana中创建索引模式并建立日志告警。
7.
Grafana仪表盘与可视化
安装Grafana:docker run -d -p 3000:3000 grafana/grafana。添加Prometheus为数据源,导入社区Dashboard或自建:站点可用性、响应时间、错误率、CPU/内存。小分段:使用变量(datasource、instance、site)以便复用,保存并分享Dashboard JSON以版本化管理。
8.
告警策略与Alertmanager配置
在Prometheus定义alerting rules,例如高延迟或错误率:ALERT HighRequestLatency IF histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket[5m])) by (le,instance)) > 1。小分段:Alertmanager配置route与receiver,配置滑动窗口(group_wait、group_interval、repeat_interval)并对接Slack/PagerDuty/Webhook。
9.
告警分级与值班流程落地
制定S1/S2/S3等级标准,明确响应时限与升级链条(页面 -> 电话 -> 经理)。小分段:在Alertmanager中基于标签routing_key进行分流:site=tw走台湾值班组,severity=critical走电话与SMS。
10.
自动化修复(Self-healing)实现步骤
用Ansible/脚本实现常见故障自动化修复示例:当某服务连续3次健康检查失败,调用Ansible playbook重启服务。小分段:Alertmanager通过Webhook触发CI/CD或运行脚本。示例Webhook处理脚本接收alert后执行:ansible-playbook -i inventory/hosts restart-service.yml --extra-vars "target=site-tw-web01"
11.
运行手册与Runbook编写要点
为每个告警编写Runbook:触发条件、初步诊断命令、临时修复命令、长期根因排查步骤、回溯指令。小分段:示例命令:检查进程 ps aux | grep nginx; 查看日志 tail -n 200 /var/log/nginx/error.log; 重启服务 systemctl restart nginx。
12.
Kubernetes环境下的监控与自愈
部署Prometheus Operator + kube-state-metrics + node-exporter。设置liveness/readiness探针并配置HPA。小分段:当Pod OOM或CrashLoop时,结合K8s事件与Prometheus告警触发自动扩容或回滚Deployment:kubectl rollout undo deployment/web --namespace=prod。
13.
演练与SLA评估
定期进行故障演练(每季度),模拟数据库宕机、负载洪峰、跨机房链路断开,评估告警准确性与响应流程。小分段:记录演练报告,调整告警阈值、抑制误报、优化自动化脚本。
14.
运维工具与权限控制
为运维账号建立最小权限策略,使用Vault或Secrets Manager集中管理API密钥与凭证。启用Grafana/Prometheus的RBAC与审计。小分段:示例:Prometheus读取权限仅允许抓取端点;Grafana只给值班账号Dashboard查看和告警确认权限。
15.
监控复原与容量规划
持续记录历史指标用于容量规划,配置Prometheus远端存储(Thanos/Long-term storage)保证指标长期可追溯。小分段:按月评估资源使用趋势,提前触发扩容工单或自动扩容策略。
16.
部署检查清单(上线前必须项)
1) 各站点probe覆盖率达到100%。 2) 告警规则已覆盖关键SLA项。 3) Runbook完成并验证。 4) 自动化修复脚本在预演环境通过。小分段:上线后72小时内加强观察并设置更低阈值用于捕捉潜在问题。
17.
问:如何快速定位台湾站群中单点站点的可用性下降?
回答步骤:1) 查看Blackbox/合成监测Probe的失败详情(Prometheus target/探测HTTP状态码)。2) 在Grafana查看该站点的响应时间与错误率趋势。3) 检查该站点主机的node_exporter指标(CPU/内存/网络)。4) 查看Nginx/应用日志(Fluent Bit/Kibana)定位错误码与堆栈。5) 若为进程异常,执行systemctl status/重启或触发Ansible修复。18.
问:当Prometheus告警频繁抖动(flapping)怎么办?
回答步骤:1) 检查告警表达式是否过于敏感,改用rate()或avg_over_time()平滑指标。2) 在Prometheus规则中增加for字段(例如for: 5m)避免瞬时噪声。3) 使用Alertmanager的抑制规则(mute)对已知维护窗口抑制告警。4) 检查采集间隔 scrape_interval 是否合理。19.
问:如何实现从告警到自动修复的端到端流程?
回答步骤:1) 在Prometheus定义明确的告警规则并打tag。2) Alertmanager将标签路由到Webhook。3) Webhook服务验证告警并调用Ansible/Terraform或K8s API执行修复Playbook(如重启服务、扩容Pod)。4) 修复后Webhook向Alertmanager发送已解决事件,或让Prometheus指标回稳自动关闭告警。5) 全流程需记录审计日志并在Runbook中说明回滚步骤。相关文章
-
如何选择适合的台湾文件服务器进行数据存储
如何选择适合的台湾文件服务器进行数据存储 在如今的信息化时代,选择一个合适的文件服务器对于数据存储至关重要,尤其是在台湾地区,随着互联网的发展,文件服务器的选择也愈发重要。本文将详细指导您如何选择适合的台湾文件服务器进行数据存储。 以下是选择台湾文件服务器的详细步骤。 1. 确定存储需求 首先,您需要明确自己的存储需求。包括以下几个方面:2025年8月25日 -
申请台湾服务器账号的步骤
申请台湾服务器账号的步骤 首先,您需要选择一个可靠的台湾服务器提供商。您可以通过搜索引擎或咨询朋友等途径来了解不同的提供商。确保提供商具有稳定的网络连接和优质的客户服务。 访问您选择的台湾服务器提供商的网站,并点击注册按钮。根据网站的指引填写必要的信息,包括用户名、密码和联系方式等。 在注册完成后,您将进入提2025年3月5日 -
腾讯云台湾服务器优势及服务特点
腾讯云台湾服务器优势及服务特点 腾讯云作为国内领先的云计算服务提供商,其在台湾地区拥有一系列优势。首先,台湾地理位置优越,位于亚洲重要的网络枢纽地带,连接东亚和东南亚地区,网络延迟低,网络质量高。其次,台湾政府对云计算产业发展支持力度大,法规环境友好,为腾讯云在台湾提供了良好的发展环境。此外,台湾拥有成熟的技术人才和互联网基础2025年6月8日 -
台湾X站交流群:畅谈台湾话题的最佳平台
台湾X站交流群:畅谈台湾话题的最佳平台 台湾作为一个多元文化的地域,拥有独特的历史和文化背景,吸引了众多人们的关注。对于热爱台湾文化的人们来说,找到一个可以畅所欲言、交流分享的平台是非常重要的。台湾X站交流群就是这样一个理想的选择。本文将介绍台湾X站交流群的特点和优势。2025年2月23日 -
台湾轮机房的设计与建设标准解析
台湾轮机房设计与建设的精华要点 在探讨台湾的轮机房设计与建设标准时,有几个关键要点必须深入了解。这不仅关乎工程的安全性与可靠性,更是提升整体性能的基础。以下是本篇文章的三大精华要点: 1. 设计标准的重要性 2. 建设过程中的关键步骤 3. 未来发展趋势与挑战 台湾的轮机房是海洋工程的重要组成部分,其设计与建设标准2026年2月26日 -
高速大带宽台湾服务器,助力网站加速
高速大带宽台湾服务器,助力网站加速 随着互联网的迅猛发展,网站加载速度成为了用户体验的重要指标之一。为了提高网站的访问速度,许多网站管理员开始寻找高速大带宽服务器来托管他们的网站。在台湾,有许多供应商提供高速大带宽的服务器服务,为网站加速提供了有力的支持。 台湾服务器2025年2月13日 -
台湾原生IP云服务器提供最佳服务
台湾原生IP云服务器提供最佳服务 随着互联网的发展,云服务器已经成为许多企业和个人的首选。在选择云服务器提供商时,性能、稳定性和服务都是重要考虑因素。而台湾原生IP云服务器正是满足这些要求的最佳选择。 台湾原生IP云服务器采用最先进的硬件设备,配备高性能的处理器和大容量内存,能够确保用户的网站和应用程序运行流畅,响应速度快。无论2025年6月29日 -
台湾网络服务器端口:全面了解和优化的指南
台湾网络服务器端口:全面了解和优化的指南 在台湾的网络服务器中,端口是一个重要的概念。了解和优化服务器端口对于确保网络安全、提高网络性能和优化用户体验至关重要。本指南将全面介绍台湾网络服务器端口的概念、功能和优化方法。 服务器端口是服务器上用于接收和发送数据的虚拟通道。它们是网络通信的关键组成部分,可用于识别不同的网络服务或应用程序2025年4月16日 -
台湾服务器托管价格分析支持下的供应商议价策略与技巧
1. 台湾服务器市场与价格概览 ① 台湾主要机房集中在台北与新北,带宽资源与成本差异明显。 ② 按实例计费的VPS与独立机房托管(Rack/整机)在价格上有显著差距。 ③ 下表展示常见配置与台湾市场参考价(含税/元新台币,月付示例)。 类型配置带宽月价(NT$) VPS 基础2 vCPU / 4GB RAM / 80GB SSD2TB 流量302026年10月13日